こんにちは、miwa-Hです。
今回は、PLINKを使った主成分分析(PCA)の話題です。
GWASの前処理において、「そもそもこのサンプルはどういう特徴を持つ集団だろう?(=どういう集団構造を持つのだろう?)」ということを確かめるステップは非常に重要です。
ここでは主成分分析については詳しく解説しませんが、高次元の「遺伝子変異データ」を要約することで、サンプル間の関係を可視化・分析しやすくしている、というふうにご理解ください。
参考:主成分分析 | 固有値問題を利用した主成分分析の解き方と R / prcomp 関数の使い方
作業環境
- Ubuntu 22.04
- PLINK v1.9.0 (64 bit)
- R v4.4.2
- ggplot2 v4.0.3
作業の流れ
- 解析したいデータを用意する
- PLINKのフォーマットに変換・フィルタリングをおこなう
- 主成分分析を実行する
- 主成分分析の結果を可視化する
やってみよう
1. 解析したいデータを用意する
ここでは、ヒトの遺伝的多様性に関する国際的なプロジェクト・データベースである、1000 Genomes Project のデータを使ってみようと思います。
染色体すべてを使用すると処理が重くなるため、今回は21番染色体のみを用います。
# ダウンロード  # 少し時間がかかります
wget "https://ftp.1000genomes.ebi.ac.uk/vol1/ftp/data_collections/1000G_2504_high_coverage/working/20220422_3202_phased_SNV_INDEL_SV/1kGP_high_coverage_Illumina.chr21.filtered.SNV_INDEL_SV_phased_panel.vcf.gz"
お手持ちの解析データ(VCF形式)がある方はそちらをご準備ください。複数サンプルのVCFを統合する方法などは、以前の下記投稿などをぜひご参照ください。
2. PLINKのフォーマットに変換・フィルタリングをおこなう
まずはPLINKをダウンロードしましょう。下記からお手元の環境にあったバージョンをダウンロードしてください。
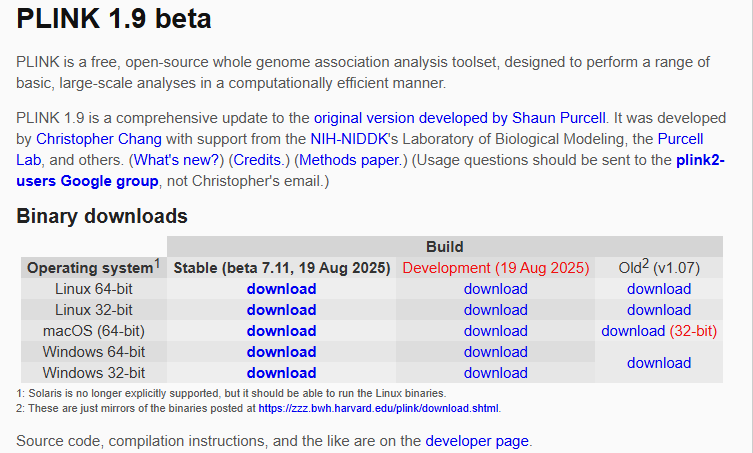
ダウンロードしたものを解凍すると、plinkというファイルがあります。これが今回使うPLINK本体です。
$ ./plink
PLINK v1.9.0-b.7.11 64-bit (19 Aug 2025)           cog-genomics.org/plink/1.9/
(C) 2005-2025 Shaun Purcell, Christopher Chang   GNU General Public License v3

  plink <input flag(s)...> [command flag(s)...] [other flag(s)...]
  plink --help [flag name(s)...]

Commands include --make-bed, --recode, --flip-scan, --merge-list,
--write-snplist, --list-duplicate-vars, --freqx, --missing, --test-mishap,
--hardy, --mendel, --ibc, --impute-sex, --indep-pairphase, --r2, --show-tags,
--blocks, --distance, --genome, --homozyg, --make-rel, --make-grm-gz,
--rel-cutoff, --cluster, --pca, --neighbour, --ibs-test, --regress-distance,
--model, --bd, --gxe, --logistic, --dosage, --lasso, --test-missing,
--make-perm-pheno, --tdt, --qfam, --annotate, --clump, --gene-report,
--meta-analysis, --epistasis, --fast-epistasis, and --score.

"plink --help | more" describes all functions (warning: long).
./plinkでバージョン情報、./plink --helpでヘルプが見られます。
では、用意したVCFをPLINKのバイナリ形式(bed/bim/fam)ファイルに変換しつつ、フィルタリングをおこないましょう。
下記のコマンドを実行します。
./plink \
--vcf 1kGP_high_coverage_Illumina.chr21.filtered.SNV_INDEL_SV_phased_panel.vcf.gz \
--biallelic-only --geno 0.01 --maf 0.05 --snps-only --mind 0.01 \
--out 1kGP_chr21 --make-bed
実際に実行してみるとこんな感じです。
$ ./plink --vcf 1kGP_high_coverage_Illumina.chr21.filtered.SNV_INDEL_SV_phased_panel.vcf.gz --biallelic-only --geno 0.01 --maf 0.05 --snps-only --mind 0.01 --out 1kGP_chr21 --make-bed
PLINK v1.9.0-b.7.11 64-bit (19 Aug 2025)           cog-genomics.org/plink/1.9/
(C) 2005-2025 Shaun Purcell, Christopher Chang   GNU General Public License v3
Logging to 1kGP_chr21.log.
Options in effect:
  --biallelic-only
  --geno 0.01
  --maf 0.05
  --make-bed
  --mind 0.01
  --out 1kGP_chr21
  --snps-only
  --vcf 1kGP_high_coverage_Illumina.chr21.filtered.SNV_INDEL_SV_phased_panel.vcf.gz

128810 MB RAM detected; reserving 64405 MB for main workspace.
--vcf: 1kGP_chr21-temporary.bed + 1kGP_chr21-temporary.bim +
1kGP_chr21-temporary.fam written.
876432 out of 1002753 variants loaded from .bim file.
3202 people (0 males, 0 females, 3202 ambiguous) loaded from .fam.
Ambiguous sex IDs written to 1kGP_chr21.nosex .
0 people removed due to missing genotype data (--mind).
Using 1 thread (no multithreaded calculations invoked).
Before main variant filters, 3202 founders and 0 nonfounders present.
Calculating allele frequencies... done.
Total genotyping rate is exactly 1.
0 variants removed due to missing genotype data (--geno).
773262 variants removed due to minor allele threshold(s)
(--maf/--max-maf/--mac/--max-mac).
103170 variants and 3202 people pass filters and QC.
Note: No phenotypes present.
--make-bed to 1kGP_chr21.bed + 1kGP_chr21.bim + 1kGP_chr21.fam ... done.
(補足)オプションについては、下記の通りです。
- --biallelic-only:アリルが2種類のみのSNPを使う
- --geno 0.01:99%以上のサンプルでタイピングされているSNPを使う
- --maf 0.05:マイナーアリル頻度が5%以上のSNP
- --make-bed:PLINKのバイナリ形式(bed/bim/fam)ファイルを出力する
- --mind 0.01:99%以上のSNPがタイピングされているサンプルを使う
- --out:出力ファイル
- --snps-only:SNPのみを使う
- --vcf:入力ファイル(VCF形式)
出力ファイルを確かめると、PLINKのバイナリ形式(bed/bim/fam)ファイルが存在することがわかります。
$ ls 1kGP_chr21*
1kGP_chr21.bed  1kGP_chr21.bim  1kGP_chr21.fam  1kGP_chr21.log  1kGP_chr21.nosex
ここまで出来たら、あとは主成分分析を実行するのみです。
3. 主成分分析を実行する
PLINKでは、--pcaというオプションを指定すると主成分分析を実行することができます。
./plink --bfile 1kGP_chr21 --out 1kGP_chr21_pca --pca
実際に実行してみるとこんな感じです。
$ ./plink --bfile 1kGP_chr21 --out 1kGP_chr21_pca --pca
PLINK v1.9.0-b.7.11 64-bit (19 Aug 2025)           cog-genomics.org/plink/1.9/
(C) 2005-2025 Shaun Purcell, Christopher Chang   GNU General Public License v3
Logging to 1kGP_chr21_pca.log.
Options in effect:
  --bfile 1kGP_chr21
  --out 1kGP_chr21_pca
  --pca

128810 MB RAM detected; reserving 64405 MB for main workspace.
103170 variants loaded from .bim file.
3202 people (0 males, 0 females, 3202 ambiguous) loaded from .fam.
Ambiguous sex IDs written to 1kGP_chr21_pca.nosex .
Using up to 23 threads (change this with --threads).
Before main variant filters, 3202 founders and 0 nonfounders present.
Calculating allele frequencies... done.
Total genotyping rate is exactly 1.
103170 variants and 3202 people pass filters and QC.
Note: No phenotypes present.
Relationship matrix calculation complete.
--pca: Results saved to 1kGP_chr21_pca.eigenval and 1kGP_chr21_pca.eigenvec .
(補足)オプションについては、下記の通りです。
- --bfile:入力ファイル(バイナリ形式)
- --out:出力ファイル
- --pca:主成分分析を実行する
出力ファイルを確かめましょう。
$ ls 1kGP_chr21_pca*
1kGP_chr21_pca.eigenval  1kGP_chr21_pca.eigenvec  1kGP_chr21_pca.log  1kGP_chr21_pca.nosex
.eigenval .eigenvecファイルが作成されました。これが主成分分析の結果ファイルです(主に使うのは.eigenvecファイルになります)。
ただし、テキストエディタやhead 1kGP_chr21_pca.eigenvec で中身を見てもらえればわかるのですが、これらのファイルはただ数字が羅列されているだけで、これでは何が何やらさっぱりわかりません。
せっかく可視化しやすいように要約(=主成分分析)をしましたので、最後は綺麗にプロットしてみましょう!
4. 主成分分析の結果を可視化する
ここでは、Rを使って結果をプロットしてみます。
集団構造を見るうえでは、サンプルがそれぞれどの条件・集団に対応しているか、という情報が必要になります。
今回の1000 Genomes Project のデータの場合は、kgpパッケージからメタデータをダウンロードできます。
> library(kgp)
>
> head(kgp3)
# A tibble: 6 × 10
  fid     id      pid   mid     sex sexf   pop   reg   population         region
  <chr>   <chr>   <chr> <chr> <int> <fct>  <chr> <chr> <chr>              <chr>
1 HG00096 HG00096 0     0         1 male   GBR   EUR   British in Englan… Europe
2 HG00097 HG00097 0     0         2 female GBR   EUR   British in Englan… Europe
3 HG00099 HG00099 0     0         2 female GBR   EUR   British in Englan… Europe
4 HG00100 HG00100 0     0         2 female GBR   EUR   British in Englan… Europe
5 HG00101 HG00101 0     0         1 male   GBR   EUR   British in Englan… Europe
6 HG00102 HG00102 0     0         2 female GBR   EUR   British in Englan… Europe
参考:1000 Genomes Project Metadata • kgp
今回は、region(ヨーロッパ、東アジア、アメリカ…)によって色分けをしましょう。
お手持ちのデータで解析をされている方は、Control群、実験群などの対応が一行ずつ記載されたファイルを作成して、read.csv()などで読み込んでください。
> meta_data <- kgp3[,c("id", "region")]
>
> head(meta_data)
# A tibble: 6 × 2
  id      region
  <chr>   <chr>
1 HG00096 Europe
2 HG00097 Europe
3 HG00099 Europe
4 HG00100 Europe
5 HG00101 Europe
6 HG00102 Europe
>
> unique(meta_data$region)
[1] "Europe"     "East Asia"  "America"    "South Asia" "Africa"
.eigenvec を読み込んで、データを整形します。
> data_pca <- read.table("1kGP_chr21_pca.eigenvec", header=FALSE)
> data_pca <- data_pca[,c(1, 3, 4)]
> colnames(data_pca) <- c("id", "PC1", "PC2")
> head(data_pca)
       id         PC1        PC2
1 HG00096 -0.00946557 -0.0238269
2 HG00097 -0.01119760 -0.0266238
3 HG00099 -0.01215470 -0.0235966
4 HG00100 -0.01128330 -0.0209658
5 HG00101 -0.01275820 -0.0250084
6 HG00102 -0.01153910 -0.0239593
>
> data_pca <- merge(data_pca, meta_data, key="id")
> head(data_pca)
       id         PC1        PC2 region
1 HG00096 -0.00946557 -0.0238269 Europe
2 HG00097 -0.01119760 -0.0266238 Europe
3 HG00099 -0.01215470 -0.0235966 Europe
4 HG00100 -0.01128330 -0.0209658 Europe
5 HG00101 -0.01275820 -0.0250084 Europe
6 HG00102 -0.01153910 -0.0239593 Europe
>
寄与率(各主成分が全体のうちどの程度の情報量を持っているか)も表示しましょう。この情報はeigenvalから取得できます。
> data_val <- read.table("1kGP_chr21_pca.eigenval", header=FALSE)
> data_val_percent <- data_val[,1]/sum(data_val[,1])*100 # 百分率で計算
> names(data_val_percent) <- paste0("PC", 1:nrow(data_val))
> head(data_val_percent)
      PC1       PC2       PC3       PC4       PC5       PC6
51.020089 16.636553  5.893014  4.236687  1.834692  1.702675
>
プロットはggplot2パッケージを用いると綺麗です。
> library(ggplot2)
>
> p <- ggplot(data = data_pca, mapping = aes(PC1, PC2, color = region)) +
         xlab(paste0("PC1 (", round(data_val_percent["PC1"], digits=2), "%)")) +
         ylab(paste0("PC2 (", round(data_val_percent["PC2"], digits=2), "%)")) +
         geom_point(size=1.5, alpha=0.7) + theme_bw()
> ggsave("test.png", p)
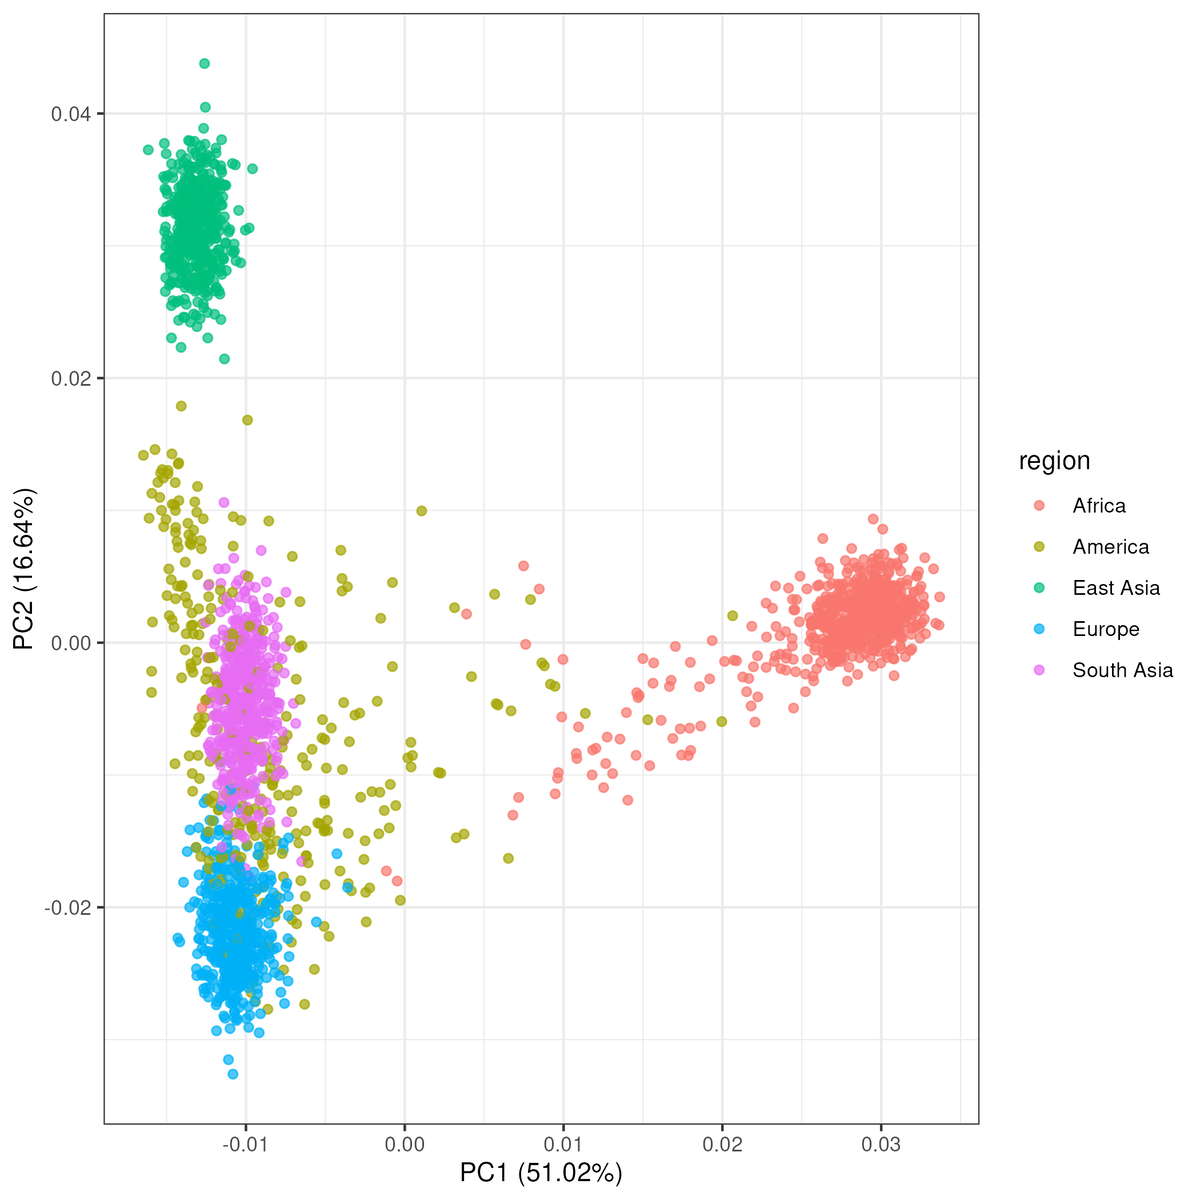
各regionの関係や、region内でのサンプルのばらつきなどが可視化されました!
皆さんもぜひ試してみてください。
